ИИ-агент для предиктивного обслуживания оборудования
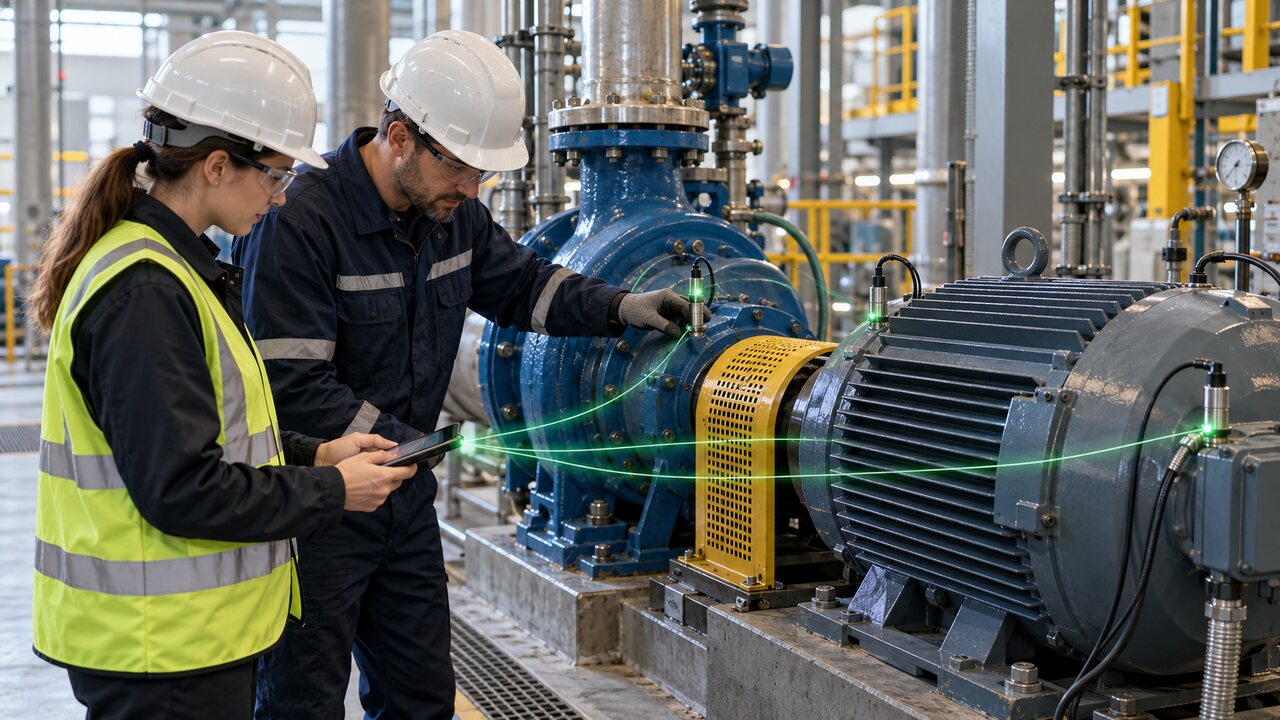
ИИ-агент для предиктивного обслуживания помогает заметить ухудшение состояния оборудования до аварийной остановки и превратить слабый сигнал в понятный план действий. Он сопоставляет телеметрию, результаты обходов, историю ремонтов, режим нагрузки и возможные последствия, а затем показывает инженеру: что именно изменилось, насколько можно доверять данным, какие версии стоит проверить и сколько времени есть на решение.
При этом агент не ставит окончательный диагноз и не должен самостоятельно управлять опасным оборудованием. Решение снизить нагрузку, остановить агрегат, назначить ремонт или продолжить наблюдение принимает ответственный специалист. Задача агента - быстрее собрать факты, не потерять важный сигнал и провести событие от первого отклонения до подтверждённого результата.
Почему одного прогноза отказа недостаточно
На производстве данные обычно есть, но лежат в разных системах. Вибрация хранится в системе мониторинга, температура - в АСУ ТП, ремонты - в EAM, результаты обходов - в мобильном приложении, а сведения о выпуске и нагрузке - в MES или сменном журнале. Каждый источник показывает только часть картины.
Допустим, температура двигателя выросла на несколько градусов. Само по себе это ещё не говорит о неисправности. Возможно, увеличилась нагрузка, изменилась температура в помещении, после мойки загрязнился фильтр или датчик начал давать погрешность. Инженеру приходится вручную восстанавливать контекст: смотреть соседние параметры, искать последние работы, звонить в смену и уточнять, что происходило с агрегатом.
Обычная аналитическая модель может показать индекс аномалии, вероятность дефекта или оценку оставшегося ресурса. Но одна цифра не отвечает на главные рабочие вопросы:
- можно ли доверять измерению;
- насколько опасно ждать;
- какую проверку разрешено провести без остановки;
- когда будет ближайшее технологическое окно;
- есть ли нужный специалист, прибор и запчасти;
- кто должен принять итоговое решение.
Если такого маршрута нет, прогноз превращается в ещё одно уведомление. Сначала команда разбирает каждую тревогу, затем видит много повторов и ложных срабатываний, а через несколько недель перестаёт воспринимать систему всерьёз.
ИИ-агент нужен как координатор процесса. Он получает событие, собирает контекст, проверяет качество данных, формирует объяснимые версии, предлагает действия только из утверждённого регламента и контролирует результат. Для подготовки и обработки потоков телеметрии подходят решения из раздела ИИ для данных, а для поиска устойчивых связей между режимом, событиями и отказами - сценарии ИИ для анализа. Когда дефект подтверждён, работа продолжается через ИИ-агента для планового обслуживания оборудования либо по внеплановому маршруту.
Что делает ИИ-агент
Работа начинается не с громкого обещания предсказать поломку, а с аккуратной регистрации отклонения. Источником может быть изменение вибрационного спектра, медленный рост температуры, увеличение потребляемого тока, падение производительности, повторяющееся замечание оператора или сочетание нескольких слабых признаков.
Дальше агент выполняет восемь практических задач.
- Определяет объект. Связывает сигнал с конкретным агрегатом, узлом, местом установки, моделью и текущим режимом работы. Это особенно важно, если в разных системах один и тот же насос записан под разными обозначениями.
- Собирает временную линию. Размещает на одной шкале измерения, аварийные сообщения, переключения режима, обходы, ремонты и замены деталей.
- Проверяет качество данных. Отмечает пропуски, задержки, рассинхронизацию часов, подозрительные скачки, зависшие значения и просроченную поверку измерительного канала.
- Ищет изменение относительно нормы. Сравнивает агрегат прежде всего с его собственной историей при сопоставимой нагрузке, а не только с общим порогом для всего класса оборудования.
- Формирует гипотезы. Для каждой версии показывает подтверждающие признаки, противоречия и недостающие сведения.
- Оценивает риск. Учитывает критичность агрегата, наличие резерва, влияние на безопасность и качество, длительность возможного простоя и цену ложной остановки.
- Предлагает следующий шаг. Это может быть повторное измерение, усиленное наблюдение, проверка в ближайшее окно или черновик ремонтной заявки.
- Замыкает цикл. Сопоставляет исходный прогноз с результатом осмотра и ремонта, чтобы правила и модели улучшались на подтверждённых фактах.
Важное отличие агента от обычной системы оповещений состоит в том, что он ведёт не отдельный сигнал, а всё событие. Инженер видит не десяток разрозненных тревог по одному насосу, а одну карточку с динамикой, контекстом, решениями и сроком следующей проверки.
Как проходит процесс: от слабого сигнала до решения
Шаг 1. Зафиксировать исходное событие
Агент сохраняет исходное значение, время, единицу измерения, качество канала и ссылку на первичную запись. Сообщение оператора также хранится без преждевременной трактовки. Фраза «насос стал звучать громче» остаётся наблюдением, а не превращается автоматически в диагноз «изношен подшипник».
Такая аккуратность нужна не ради формальности. Если версия окажется неверной, команда сможет вернуться к исходным данным и понять, на каком этапе возникла ошибка: в измерении, сопоставлении объекта, интерпретации признака или выборе действия.
Шаг 2. Учесть режим работы
Температура, вибрация и ток зависят от нагрузки, частоты вращения, продукта, температуры среды и режима запуска. Агент подбирает для сравнения действительно похожие интервалы. Если корректного аналога нет, он прямо сообщает об этом, а не подменяет неизвестность уверенным выводом.
Такой подход защищает от двух противоположных ошибок. Первая - поднять ложную тревогу после планового увеличения выпуска. Вторая - пропустить дефект, который проявляется только при определённой частоте вращения или на переходном режиме.
Шаг 3. Проверить измерительный контур
До поиска причины нужно убедиться, что сигнал реален. Агент проверяет доступность датчика, дату поверки, последние работы рядом с ним, стабильность соседних каналов и согласованность с независимыми наблюдениями.
Если один датчик мгновенно показывает скачок, а связанные параметры не меняются, первым шагом может стать повторное измерение поверенным переносным прибором. Если похожую динамику одновременно показывают несколько независимых каналов, версия реального ухудшения становится сильнее.
Шаг 4. Сформировать объяснимые гипотезы
Для каждой версии агент показывает факты в пользу, противоречия, уровень неопределённости и безопасный способ проверки. Например, рост вибрации после ремонта может указывать на нарушение центровки. Но похожая картина возникает из-за ослабления крепления, дисбаланса, дефекта подшипника или ошибки измерения.
Рейтинг вероятности помогает расставить версии по порядку, но не заменяет инженерного рассуждения. Пользователь должен видеть, почему одна гипотеза оказалась выше другой и какие новые данные способны изменить вывод.
Шаг 5. Сопоставить вероятность с последствиями
Даже редкий дефект на критичном агрегате иногда требует немедленной проверки. И наоборот, довольно вероятное отклонение на резервируемом узле можно спокойно проверить в ближайшее окно, если есть понятные контрольные границы.
Поэтому агент формирует не «магический балл», а читаемую карточку риска. В ней отдельно указаны вероятность версии, тяжесть последствий, наличие резерва, время до безопасного окна, цена ложной остановки и признаки, при которых ситуацию нужно срочно пересмотреть.
Шаг 6. Передать решение человеку
Инженер выбирает разрешённый маршрут: продолжить работу, усилить наблюдение, снизить нагрузку, провести диагностику, подготовить материалы или остановить агрегат по регламенту. Агент фиксирует автора решения, основание, контрольные границы и срок повторной оценки.
Если фактические значения выходят за установленные границы, агент поднимает событие на следующий уровень и уведомляет назначенных сотрудников. Но сам переход к опасному действию остаётся под контролем человека и действующих производственных процедур.
Шаг 7. Проверить результат
После осмотра или ремонта агент получает фактический диагноз, перечень выполненных работ и контрольные измерения после запуска. Если тревога оказалась ложной, это тоже полноценный результат. Его нельзя удалять из истории или закрывать пустой отметкой «не подтвердилось».
Без такой обратной связи система будет повторять прежние ошибки. С ней команда постепенно уточняет пороги, правила сравнения, признаки дефектов и требования к данным.
Практический сценарий: подшипниковый узел насоса
Представим насос, который подаёт охлаждающую воду на производственную линию. За десять дней среднеквадратичное значение вибрации выросло на 18 процентов. Абсолютный уровень ещё ниже аварийного порога, температура подшипника стабильна, оператор не слышит необычного шума. Простое пороговое правило не считает ситуацию опасной.
ИИ-агент сравнивает интервалы при одинаковой нагрузке и замечает устойчивый рост определённой частотной составляющей. Затем поднимает историю работ: три недели назад меняли муфту, но результат проверки центровки после запуска не приложили к заказу. Одновременно второй датчик на корпусе передаёт данные с пропусками, поэтому уверенность в выводе ограничена.
Агент не заявляет, что подшипник скоро разрушится. Он формирует две рабочие версии. Первая - нарушение центровки после замены муфты; её поддерживает момент появления тренда. Вторая - начальная деградация подшипника; на неё указывает спектральный признак, но её пока не подтверждают температура и акустика.
Для обеих версий предлагаются разрешённые действия: повторить измерение переносным анализатором, проверить крепления и проконтролировать центровку в ближайшее технологическое окно. Отдельно агент указывает, какого факта не хватает для более уверенного вывода.
Инженер назначает усиленное наблюдение на двое суток и готовит работу на плановый останов. Агент проверяет наличие специалиста, прибора и комплекта крепежа, создаёт черновик заявки и устанавливает условие немедленной эскалации, если тренд начнёт ускоряться.
Во время проверки находят небольшое смещение полумуфт. После корректировки вибрация возвращается к базовому уровню. Событие закрывается подтверждённой причиной, приложенными измерениями и результатом после запуска, а не простой отметкой «выполнено».
Польза здесь не в эффектной точности прогноза. Компания получила несколько дней на подготовку, не останавливала линию в аварийном порядке и сохранила понятное обоснование, почему работу назначили именно в это окно.
Какие данные нужны на старте
Для пилота не нужно сразу подключать всё предприятие. Лучше выбрать один тип критичного оборудования и согласовать минимальный набор данных:
- стабильный идентификатор каждого агрегата и узла;
- значения двух-пяти информативных параметров с метками времени;
- сведения о нагрузке или производительности;
- журнал аварий, запусков, остановов и переключений;
- история ремонтов и заменённых деталей;
- результаты обходов и ручных измерений;
- критичность, резервирование и допустимые окна остановки;
- фактические причины уже закрытых отказов.
Главное требование - связать записи по времени и объекту. Десять миллионов измерений без однозначного номера агрегата менее полезны, чем полгода аккуратной истории по двадцати насосам. Если в АСУ ТП объект называется P-101, в EAM - «Насос 1», а в сменном журнале - «первый охлаждающий», сначала нужен единый справочник и правила сопоставления.
Качество истории тоже важнее её объёма. Запись «заменили деталь» почти бесполезна, если неизвестно, какую именно деталь сняли, по какой причине и что изменилось после запуска. Для обучения процесса ценны подтверждённый дефект, выполненная работа и контрольный результат.
Что нельзя отдавать агенту
ИИ-агент не должен самостоятельно менять защитные уставки, отключать блокировки, запускать или останавливать опасное оборудование. Он не заменяет промышленную безопасность, инструкции производителя, нарядную систему и компетенцию ответственного инженера. Низкое качество данных нельзя скрывать за уверенной формулировкой.
Отдельные запреты нужны для действий на месте. Если проверка требует снять ограждение, открыть корпус, войти в опасную зону или работать рядом с вращающимися частями, агент обязан остановить автоматический сценарий и направить задачу квалифицированному персоналу. Срочность прогноза не отменяет допуск и процедуру блокировки энергии.
Права доступа расширяют постепенно. На первом этапе агенту достаточно читать телеметрию и историю, собирать карточку события и готовить черновик заявки. Автоматическое изменение приоритета ремонта, резервирование склада или заказ запчастей включают только после проверки маршрута и с явным подтверждением человека.
Также агент не должен скрывать альтернативные версии. Если данных недостаточно, корректный ответ звучит как «нужна дополнительная проверка», а не как точный диагноз. Чем выше цена решения, тем важнее показать происхождение данных, ограничения и человека, который подтвердил действие.
Частые ошибки внедрения
Начинать со всех активов сразу
У насосов, компрессоров, печей и редукторов разные режимы, признаки деградации и цена ошибки. Попытка сразу охватить весь парк растягивает интеграцию и делает результаты спорными. Пилот на одном семействе агрегатов быстрее показывает, работают ли данные, регламент и реакция команды.
Измерять только точность модели
Даже сильный алгоритм бесполезен, если уведомление некому разобрать или нужное окно уже прошло. Помимо precision и recall нужно измерять время от сигнала до решения, долю событий с полным контекстом, число заранее подготовленных работ и повторяемость подтверждённых дефектов.
Прятать причину тревоги
Сообщение «риск отказа 82 процента» не помогает инженеру действовать. Нужны конкретные признаки, сравнимый режим, качество данных, похожие случаи и условия, при которых вывод следует пересмотреть. Процент без объяснения создаёт видимость точности и быстро подрывает доверие.
Создавать слишком много уведомлений
Если агент сообщает о каждом небольшом отклонении, специалисты перестают реагировать. События нужно объединять по объекту, подавлять повторы и повышать приоритет только при устойчивом изменении, появлении независимого подтверждения или росте последствий.
Автоматизировать действие раньше процесса
Иногда команда пытается сразу связать тревогу с созданием срочной заявки. В результате EAM заполняется дублями, а ремонтная служба вручную отменяет лишние работы. Сначала стоит проверить карточку события и правила эскалации в режиме подсказки, затем автоматизировать хорошо изученные шаги.
Не собирать обратную связь
Закрытая заявка без фактической причины ничему не учит. В карточке должны остаться обнаруженный дефект, выполненная работа, заменённая деталь, измерение после запуска и вывод о корректности первоначальной гипотезы. Это не дополнительная отчётность, а основа для улучшения следующего решения.
Как запустить пилот за шесть этапов
1. Выбрать объект. Подойдёт семейство из 10-30 однотипных насосов, электродвигателей, компрессоров или редукторов. Желательно, чтобы по ним уже была история, понятная цена простоя и конкретный владелец процесса.
2. Описать маршрут решения. Зафиксируйте, кто рассматривает событие, какие проверки разрешены, когда требуется эскалация и кто вправе назначить останов. Агент должен встраиваться в этот маршрут, а не изобретать новый порядок на ходу.
3. Собрать базовую линию. Возьмите период нормальной работы и несколько подтверждённых дефектов. Разделите режимы, проверьте временные метки, единицы измерения и соответствие идентификаторов.
4. Настроить карточку события. На одном экране должны быть объект, изменение, источник, качество данных, рабочий контекст, гипотезы, риск и следующий шаг. Избегайте ложной точности и длинных автоматических пересказов.
5. Поработать в режиме подсказки. Первые недели агент только готовит материалы. Инженер сравнивает вывод со своей оценкой, отмечает ошибки и дополняет правила. На этом этапе особенно заметны пропуски в данных и неясные зоны ответственности.
6. Подвести итог. Через один-два ремонтных цикла оцените подтверждённые находки, выигранное время, число заранее подготовленных работ и нагрузку на специалистов. Только после этого решайте, расширять ли парк оборудования и полномочия агента.
Если пилот упирается в разрозненные интеграции и непонятные зоны ответственности, полезно начать с AI-аудита бизнес-процессов. Он помогает отделить проблему данных от проблемы маршрута решений.
Метрики, по которым виден результат
Полезный пилот меняет ежедневную работу, а не просто рисует красивый график. Для оценки подходят пять групп показателей:
- доля событий, которые успели рассмотреть до отказа или аварийной остановки;
- медианное время от первого сигнала до инженерного решения;
- доля подтверждённых дефектов среди эскалаций;
- число работ, для которых заранее подготовили окно, специалиста, прибор и материалы;
- изменение числа срочных вызовов, повторных отказов и часов незапланированного простоя.
Метрики нужно смотреть вместе. Например, высокая доля подтверждённых дефектов может означать не только хорошую точность, но и слишком осторожную настройку, при которой система замечает лишь очевидные проблемы. А резкое сокращение уведомлений ничего не доказывает, если команда стала пропускать ранние сигналы.
Экономический эффект считают осторожно. Не стоит записывать в экономию полную стоимость каждой теоретически возможной аварии. Надёжнее сравнить результат с историческим уровнем срочных работ, учитывать фактически предотвращённый простой и отдельно показать расходы на датчики, интеграции, сопровождение и время инженеров.
Практический чек-лист готовности
- Выбран конкретный тип оборудования и назначен владелец процесса.
- У объектов есть стабильные идентификаторы во всех источниках.
- Известны режимы, при которых сравнение корректно.
- Для каждого канала видны качество данных и задержка поступления.
- Утверждены безопасные проверки и точки обязательного решения человека.
- Карточка события показывает объяснение, а не только оценку риска.
- Повторные сигналы объединяются в одно событие по объекту.
- Событие можно превратить в заявку без ручного переписывания данных.
- После ремонта фиксируются подтверждённая причина и измерение результата.
- На старте права агента ограничены чтением и подготовкой действий.
- Команда согласовала метрики процесса и условия расширения пилота.
- Для опасных действий настроена жёсткая блокировка автоматического выполнения.
FAQ
Чем предиктивное обслуживание отличается от планово-предупредительного ремонта?
Плановый ремонт запускается по календарю, наработке или нормативному интервалу. Предиктивный подход учитывает фактическое изменение состояния конкретного оборудования. На практике эти подходы дополняют друг друга: обязательные регламентные работы остаются, а агент помогает точнее назначать диагностические проверки и вмешательства между ними.
Нужны ли для запуска новые датчики?
Не всегда. Пилот часто можно начать с уже доступных параметров, журналов и результатов обходов. Новые датчики нужны, если существующие данные не отражают нужный вид деградации или имеют недостаточное качество. Решение о покупке лучше принимать после проверки конкретного сценария, а не заранее для всего парка.
Может ли ИИ-агент точно назвать дату отказа?
Обычно безопаснее давать диапазон и явно указывать неопределённость, а не обещать точную дату. Остаточный ресурс зависит от нагрузки, режима, качества предыдущего ремонта и внешних условий. Практическая задача агента - дать достаточно времени для проверки и подготовки обоснованного решения.
Что делать, если предупреждение оказалось ложным?
Нужно сохранить его как полноценный результат: какие данные вызвали тревогу, что проверили и почему дефект не подтвердился. После этого можно скорректировать правила сравнения, требования к качеству канала или порог эскалации. Ложные срабатывания нельзя просто удалять из истории, иначе система не сможет на них учиться.
Кто отвечает за итоговое решение?
Ответственность остаётся у назначенного специалиста предприятия. Агент собирает факты, показывает риск, предлагает разрешённые действия и контролирует маршрут, но не заменяет допуски, регламент безопасности и инженерное решение.
Что делать, если данных мало?
Начать с простых правил качества и сопоставления режимов. Даже без сложной модели агент может собрать историю по объекту, обнаружить пропуски, связать отклонение с последним ремонтом и подготовить проверку. По мере накопления подтверждённых случаев можно добавлять более сложную аналитику.
Когда можно масштабировать пилот?
Когда события стабильно связываются с правильными объектами, команда понимает объяснения, опасные действия блокируются, а обратная связь после ремонта действительно заполняется. После этого сценарий расширяют на другие агрегаты или дают агенту больше прав в пределах утверждённого процесса.
Сколько времени нужно, чтобы увидеть пользу?
Это зависит от частоты событий и ремонтного цикла. Если дефекты возникают редко, нельзя оценивать пилот только по календарному сроку. Нужен достаточный набор реальных эпизодов: ранние сигналы, инженерные решения, проверки и подтверждённые результаты. Иногда на это уходит несколько недель, иногда - несколько месяцев.
ИИ-агент для предиктивного обслуживания ценен не обещанием безошибочно предсказать каждую поломку. Он создаёт дисциплинированный цикл: заметить изменение, проверить данные, оценить риск, подготовить действие и подтвердить результат. Именно такой цикл превращает телеметрию в более управляемый ремонт, меньшее число срочных работ и решения, которые можно объяснить и проверить.
Получить карту автоматизации
Разберём, как устроено обслуживание вашего оборудования, какие сигналы уже доступны и где ИИ-агент поможет раньше заметить риск, подготовить проверку и довести решение до результата.
Пройти диагностику